In einem industriellen Umgebung, isoliert eines System kann enthalten eine Drohung oder Unterbrechung eine kritische Prozess.
Eine wirksame Reaktion hängt davon ab, dass man sich darüber einigt, wer die Entscheidungen trifft, welche Nachweise benötigt werden und wie die Sicherheits-und Einsatzkräfte zusammenarbeiten werden.
Wer entscheidet , ob ob isoliert ein OT System? Entdecken wie Sicherheit, Betrieb und Management können vorbereiten auf schwierige industrielle Eindämmung Entscheidungen.
Im OT ist die Eindämmung nicht nur eine reine Sicherheitsmassnahme. Es handelt sich um eine betriebliche Entscheidung mit Auswirkungen auf die Sicherheit, den Schutz und das Geschäft.
Die meisten Incident-Response-Pläne sind klar, bis die folgenreichste Entscheidung ansteht.
Ein betroffenes System wurde identifiziert, die Aktivität wirkt verdächtig und das Security Team empfiehlt Massnahmen zur Eindämmung des Incidents. Nun muss jemand entscheiden, ob das System isoliert, ein Kommunikationspfad gesperrt oder der Fernzugriff eingeschränkt wird.
In einer IT-Umgebung ist die Isolation eines Endpoints häufig eine etablierte erste Massnahme. Der Benutzer verliert zwar möglicherweise den Zugriff, und einige Arbeitsabläufe werden unterbrochen, doch diese Massnahme schränkt die Möglichkeiten des Angreifers ein, weiterzumachen.
In OT kann dieselbe Entscheidung ganz andere Folgen haben.
Eine Engineering Workstation unterstützt möglicherweise mehrere Produktionslinien. Ein scheinbar gewöhnlicher Windows-Server koordiniert einen Batch-Prozess. Eine Remote-Verbindung wird benötigt, um kritische Maschinen am Laufen zu halten. Die Blockierung der Kommunikation zu einem Subsystem kann die Überwachung oder Steuerung beeinträchtigen.
Containment kann dennoch erforderlich sein. Entscheidend ist, ob die Organisation schnell die sicherste Variante bestimmen kann und dabei sowohl die Cyberbedrohung als auch den physischen Prozess ausreichend versteht.
Diese Entscheidung darf nicht allein beim ersten Analysten liegen, der den Alert sieht.
Eine technisch einfache Massnahme mit komplexen Folgen
Angenommen, das SOC eines Energieversorgers erkennt ungewöhnliche Kommunikation einer Engineering Workstation, die mehrere Umspannwerke im Stromnetz unterstützt.
Die Workstation verbindet sich mit einem System, das sie normalerweise nicht erreicht. Die Aktivität folgt auf eine Remote Session eines Maschinenherstellers. Der Analyst kann zunächst nicht bestätigen, ob die Verbindung mit genehmigten Wartungsarbeiten zusammenhängt. Aus Security-Sicht wäre eine Isolation nachvollziehbar.
OT Operations zögert jedoch, weil dieselbe Workstation gerade zur Untersuchung einer Störung an einem anderen Standort eingesetzt wird. Eine Trennung würde die Stromversorgung nicht unmittelbar unterbrechen, könnte die Diagnose aber erschweren.
Die Arbeitsstation wird außerdem zur Untersuchung einer Störung an einem anderen Standort genutzt. Ein Abschalten der Station würde zwar die Stromversorgung nicht unterbrechen, könnte jedoch die Möglichkeiten der Techniker zur Diagnose des aktuellen Problems einschränken. Der Remote-Anbieter ist nicht mehr verbunden, obwohl seine Arbeit möglicherweise die veränderten Kommunikationsmuster erklärt.
Der Remote-Anbieter ist nicht mehr verbunden, obwohl seine Arbeit möglicherweise die veränderten Kommunikationsmuster erklärt. Gleichzeitig ist unklar, ob sich die verdächtige Aktivität bereits ausgebreitet hat.
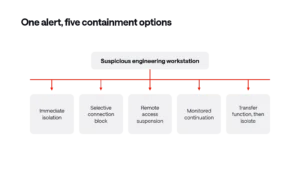
Die Organisation hat mehrere unvollkommene Optionen:
- die Workstation sofort isolieren und die betrieblichen Auswirkungen akzeptieren
- nur die unerwartete Kommunikation einschränken
- Remote Access aussetzen und das System während der Untersuchung weiter überwachen
- die operationale Funktion des betroffenen Systems vor deren Isolierung auf ein anderes System verlagern
- für einen begrenzten Zeitraum weitere Nachweise sammeln
Jede Option verschiebt das Verhältnis zwischen Cyberrisiko und Betriebsrisiko.
Die technisch einfachste Massnahme ist nicht automatisch die operativ sicherste. Auf vollständige Gewissheit zu warten kann jedoch ebenso gefährlich sein.
Wer hat die Entscheidungsbefugnis?
Viele Incident-Response-Pläne regeln Untersuchung, Kommunikation und Eskalation. Weniger häufig legen sie ausdrücklich fest, wer entscheiden darf, wenn Eindämmungsmassnahmen die Produktion, Safety oder Service Delivery beeinflussen.
Das SOC kann Threat Activity bewerten, den betroffenen Umfang eingrenzen und Sicherheitsmassnahmen empfehlen. Es kann jedoch selten die vollständigen betrieblichen Folgen einer OT-Isolation beurteilen.
OT Operations kennt den Produktionsprozess und weiss, ob Anlagen gestoppt, manuell betrieben oder über ein alternatives System unterstützt werden können. Dafür fehlt dort möglicherweise der Security-Kontext zur möglichen Ausbreitung einer Bedrohung.
Bei erheblichen Sicherheits-, Finanz-, Lieferketten- oder regulatorischen Auswirkungen muss das Management einbezogen werden. Trotzdem sollte nicht jede technische Entscheidung auf die Teilnahme einer Führungskraft warten.
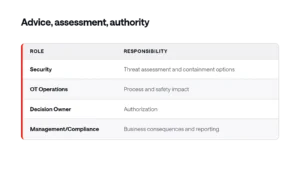
Ein funktionierendes Modell unterscheidet klar zwischen fachlicher Empfehlung, operativer Bewertung und formaler Entscheidungsbefugnis:
- Security charakterisiert die Bedrohung, grenzt den Scope ein und schlägt Eindämmunsmassnahmen vor.
- OT Operations bewertet Prozessabhängigkeiten, sichere Zustände und die Folgen jeder Option.
- Der benannte Entscheidungsträger genehmigt Massnahmen mit wesentlichen Auswirkungen auf Produktion, Sicherheit oder Service Delivery.
- Management, Legal und Compliance werden einbezogen, sobald definierte Business- oder Meldegrenzen erreicht sind.
Die Rollen unterscheiden sich nach Organisation und Standort. Entscheidend ist, dass die Beteiligten die Entscheidungshierarchie nicht erst während eines Vorfalls klären müssen.
Ein Playbook muss Entscheidungen beschreiben, nicht nur Schritte
Viele Playbooks folgen einer logischen Sequenz: erkennen, analysieren, eindämmen, beseitigen und wiederherstellen.
Diese Abfolge ist hilfreich, bildet aber die Unsicherheit von OT Eindämmungsmassnahmen nur unzureichend ab.
Das betroffene System isolieren klingt eindeutig, bis dieses System einen Prozess steuert, der nicht sofort unterbrochen werden kann. Schädliche Kommunikation blockieren setzt voraus, dass das Team weiss, welche Verbindung schädlich ist und welcher Datenverkehr für den Prozess benötigt wird. Den Asset Owner einbeziehen hilft wenig, wenn die Verantwortung zwischen Werk, zentralem Engineering und Gerätehersteller verteilt ist.
Ein praxistaugliches OT-Playbook sollte deshalb beantworten:
Ein praxistaugliches OT-Playbook sollte deshalb beantworten:
- Welche betriebliche Funktion erfüllt das System?
- Was geschieht, wenn es nicht verfügbar ist?
- Gibt es einen redundanten, manuellen oder eingeschränkten Betriebsmodus?
- Welche Netzwerkverbindungen sind für die Funktion unverzichtbar?
- Wer kann genehmigte Arbeiten bestätigen?
- Welche Eindämmungsmassnahmen sind vorab autorisiert?
- Wer entscheidet, wann Produktionskontinuität vorübergehend Vorrang erhält?
- Wann müssen Management, Safety, Legal oder Compliance beteiligt werden?
Diese Fragen lassen sich in der Vorbereitung leichter klären als während eines Vorfalls. Sie decken zudem Lücken auf, die eine rein technische Übung übersieht, etwa veraltete Kontakte, Abhängigkeiten von Anbietern oder einen nicht getesteten Fallback-Prozess.
Ein Incident-Response-Plan beschreibt, was geschehen soll. Das Betriebsmodell legt fest, wer entscheiden darf, wenn die sicherste Massnahme nicht eindeutig ist.
Die Herausforderung eines externen SOC
Die Entscheidung wird schwieriger, wenn Monitoring und Erstuntersuchung bei einem externen SOC oder Managed Security Service Provider liegen.
Ein externer Analyst kann einen Alert und relevante Netzwerkdaten sehen. In der Regel kennt er aber nicht jeden Produktionsprozess, Wartungsplan und lokalen Betriebszustand.
Der Alert kann zeigen, dass ein industrielles Asset plötzlich eine unerwartete Zonengrenze überschreitet. Der Provider muss dennoch wissen, ob die Verbindung eine geplante Modernisierung unterstützt, ein sicherheitsrelevantes System erreicht und welcher Ansprechpartner am Standort zuständig ist.
Eine generische Verteilerliste oder veraltete Telefonnummer kostet wertvolle Zeit.
Ein belastbares externes Betriebsmodell benötigt deshalb mehr als das Weiterleiten von Alerts:
- aktuelle Standort- und Asset-Verantwortlichkeiten
- klare Severity- und Eskalationskriterien
- benannte operative Ansprechpartner für kritische Standorte
- Zugriff auf relevante historische Kommunikation
- Vorgaben für Massnahmen, die empfohlen oder eingeleitet werden dürfen
- einen definierten Weg für dringende Eindämmungs-Entscheidungen
Das SOC muss nicht zum Anlageningenieur werden. Es braucht einen verlässlichen Weg, Engineering und den OT-Betrieb mit ausreichend gemeinsamer Evidenz in die Untersuchung einzubeziehen.
Die Informationen hinter der Entscheidung
Auch ein klares Autoritäts-Modell scheitert, wenn aktuelle Informationen fehlen.
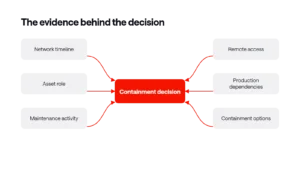
Im beschriebenen Versorgungsszenario kann der Entscheidungsträger nicht allein anhand eines Alerts zwischen Isolation und weiterer Beobachtung wählen. Das Team muss wissen, wann die Kommunikation begann, ob sie auf die Hersteller-Session folgte, welche Systeme erreicht wurden und ob das Verhalten früher bereits auftrat.
Ebenso wichtig sind die Abhängigkeiten der Workstation. Unterstützt sie aktuell die Störungsdiagnose? Kann diese Funktion verlagert werden? Würde das Blockieren einer einzelnen Verbindung ausreichen, ohne die Workstation vollständig ausser Betrieb zu nehmen?
Kontinuierliche OT-Visibilität und historische Netzwerkdaten werden damit zu einem Bestandteil der Incident Response.
Relevanter Kontext umfasst:
- die beteiligten Assets und Kommunikationspfade
- das erste und jüngste Auftreten dieser Aktivität
- Zonengrenzen
- zeitgleiche Remote- und Wartungsaktivität
- Firewall-Änderungen
- Systemverantwortliche
- die erwarteten Folgen verschiedener Massnahmen
Keine Monitoring-Plattform kann die finale operative Entscheidung übernehmen. Sie kann jedoch die Faktenlage verbessern, auf der diese Entscheidung beruht.
Entscheidungen vorbereiten, die sich nicht automatisieren lassen
Automatisierung ist sinnvoll, wenn eine Organisation eine sichere und wiederholbare Response definieren kann. Bekannte schädliche externe Infrastruktur lässt sich möglicherweise automatisch blockieren. Ein Hersteller-Account kann nach Ablauf des genehmigten Zugriffsfensters deaktiviert werden. Ein verdächtiger IT Endpoint lässt sich isolieren, bevor die Aktivität die Produktion erreicht.
Je tiefer die Massnahme in die OT-Umgebung eingreift, desto mehr Vorsicht ist erforderlich.
Eine anomal wirkende Verbindung kann eine undokumentierte Produktionsabhängigkeit bedienen. Ein Legacy-System startet nach einer Trennung womöglich nicht sauber. Die Isolation eines einzelnen Geräts kann mehrere Produktionslinien beeinflussen, weil sich die Architektur seit der Definition der Regel verändert hat.
Das bedeutet nicht, dass jede OT-Massnahme auf ein Komitee warten muss.
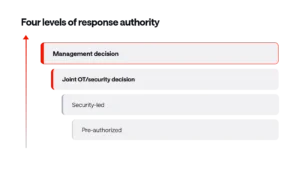
Die Organisation sollte vorab festlegen, welche Aktionen automatisiert, durch Security geführt, gemeinsam entschieden oder vom Management genehmigt werden:
- Vorab autorisiert: bekannte schädliche externe Infrastruktur oder abgelaufenen Remote Access blockieren
- Security-geführt: Aktivität ohne bekannte Produktionsabhängigkeit einschränken
- Gemeinsame Entscheidung: Engineering Workstation isolieren oder Kommunikation innerhalb der Produktion sperren
- Managemententscheidung: Massnahmen mit wesentlichen Folgen für Sicherheit, Service oder Geschäft
Diese Kategorien müssen an realen Prozessen getestet werden: Eine szenariobasierte Notfallübung (Tabletop Exercise) zeigt, ob die richtigen Personen rechtzeitig die richtigen Informationen erhalten.
Was eine Tabletop Exercise aufzeigen sollte
Eine gute OT-Übung testet nicht primär, ob die Teilnehmenden den Incident-Response-Plan auswendig kennen. Sie prüft, ob die Organisation unter unvollständiger Faktenlage eine schwierige Entscheidung treffen kann.
Ein Szenario könnte mit einer Remote-Wartungs-Session in einer Kläranlage beginnen. Kurz darauf entsteht eine neue Verbindung zwischen einer Engineering Workstation und Systemen in einem anderen Prozessbereich. Der Analyst kann nicht feststellen, ob sie zu den Wartungsarbeiten gehört. Der Hersteller ist zunächst nicht erreichbar und die Anlage läuft nahe an ihrer Kapazitätsgrenze.
Die Teilnehmenden müssen entscheiden:
- Welche zusätzlichen Nachweise werden zuerst benötigt?
- Wer kontaktiert den Standort und den Anbieter?
- Welche Eindämmungsmassnahmen sind technisch möglich?
- Welche betrieblichen Folgen hätte jede Option?
- Wer darf die Massnahme genehmigen?
- Wie lange kann die Organisation vor einer Entscheidung warten?
- Welche Informationen werden für Reporting und Review gesichert?
Das wertvollste Ergebnis ist nicht zwingend eine schnellere Antwort. Häufig ist es die Erkenntnis, welche Information, Befugnis oder Kontaktperson gefehlt hat.
Diese Lücken lassen sich vor einem realen Vorfall schliessen.
Resilienz zeigt sich im Eskalationsprozess
Gemeinsam nutzbare Netzwerkdaten und historischer Kontext bilden eine wichtige Grundlage für dieses Betriebsmodell. Sie helfen OT-Teams, internen oder externen SOCs und Entscheidungsträgern, mit derselben Timeline zu arbeiten, ohne vorhandene Spezialtools oder operative Expertise zu ersetzen.
Technologie unterstützt die Entscheidung. Sie trifft sie nicht.
Eine Organisation kann über ausgereifte Detection, gute Segmentierung und detaillierte Incident-Response-Dokumentation verfügen und dennoch Schwierigkeiten haben, sobald über die Unterbrechung eines industriellen Prozesses entschieden werden muss. In diesem Moment wird operative Resilienz konkret: Die richtigen Personen sind verfügbar, Zuständigkeiten sind geklärt und die Evidenz reicht aus, um zwischen unvollkommenen Optionen zu wählen.
Kein Playbook beseitigt die Unsicherheit einer OT Incident Response vollständig. Ein gutes Betriebsmodell verhindert jedoch, dass unklare Zuständigkeiten und fehlender Kontext diese Unsicherheit zusätzlich vergrössern.
Die wichtigsten Erkenntnisse
- OT-Eindämmung kann betriebliche und sicherheitsrelevante Folgen haben, die bei einer typischen IT-Response nicht auftreten.
- Security charakterisiert die Bedrohung und schlägt Optionen vor; der OT-Betrieb bewertet Prozessauswirkungen und sichere Betriebszustände.
- Die finale Entscheidungsbefugnis muss vor einem Vorfall festgelegt sein.
- Externe SOC-Provider benötigen klare Eskalationswege und operativen Kontext, nicht nur OT-Alerts.
- Tabletop Exercises sollten Entscheidungen unter unvollständigen Informationen testen und nicht nur Verfahrensschritte einüben.
Weiterlesen
OT-Security ohne zusätzlichen Aufwand
Wie können Unternehmen Transparenz, betrieblichen Kontext und die Reaktion auf Vorfälle zu einem praxisorientierten Resilienzmodell verknüpfen?
Laden Sie das Whitepaper „OT-Security ohne Mehraufwand“ herunter und erfahren Sie, wie OT- und Sicherheitsteams sich auf Eindämmungsmassnahmen vorbereiten, ein gemeinsames Lagebild erstellen und im Falle eines Vorfalls zuverlässige Nachweise liefern können.
OT Security Evaluation Guide
Die OT-Sicherheitsbewertung Leitfaden enthält praktische Fragen zur Bewertung der Zuständigkeit für die Reaktion, der SOC-Integration, der historischen Nachweise und der Fähigkeit, Vorfälle zu untersuchen, ohne den Betrieb zu stören.